


Di industri teknologi, Anda hampir tidak dapat melakukan percakapan tanpa ada yang menyebutkan inferensi, kecerdasan buatan (AI), dan pembelajaran mesin (ML). Namun, penting untuk dicatat bahwa meskipun semua istilah ini saling berhubungan, istilah-istilah tersebut juga berbeda secara signifikan.
Dalam artikel ini, kami akan menjelaskan perbedaan mendasar dan menyoroti pentingnya penggunaan teknologi edge AI berbasis pemrosesan tensor, khususnya pada sistem edge dan sistem tertanam. Dibandingkan dengan solusi berbasis unit pemrosesan grafis (GPU), unit pemrosesan tensor (TPU) menawarkan kinerja yang lebih efisien dan-efektif biaya. Kami juga akan memberikan beberapa contoh kasus penggunaan yang mengilustrasikan di mana Anda mungkin menemukan solusi edge AI di masa depan.
Dasar-dasar ML dan Inferensi
ML mengacu pada metodologi model pelatihan yang menggunakan data representatif untuk memungkinkan mesin mempelajari cara melakukan tugas. Proses ini bisa sangat intensif secara komputasi, menghasilkan triliunan operasi per titik data pelatihan baru. Sifat proses pelatihan yang berulang, dikombinasikan dengan kumpulan data pelatihan yang sangat besar yang diperlukan untuk mencapai akurasi tinggi, mendorong permintaan akan pemrosesan titik mengambang-kinerja-yang sangat tinggi. Pelatihan ML paling baik diterapkan sebagai infrastruktur pusat data, di mana biaya modal dan operasional yang tinggi dapat dibenarkan dengan mengamortisasikannya ke banyak pelanggan.
Inferensi melibatkan penggunaan model yang dilatih untuk menghasilkan potensi kecocokan untuk data baru yang relevan dengan data representatif yang menjadi dasar model dilatih. Inferensi bertujuan untuk memberikan jawaban cepat dalam milidetik. Contoh inferensi mencakup pengenalan ucapan,-terjemahan bahasa real-time, visi mesin, dan keputusan pengoptimalan penyisipan iklan. Meskipun inferensi hanya memerlukan sebagian kecil dari kekuatan pemrosesan yang diperlukan untuk pelatihan, inferensi masih jauh melebihi apa yang dapat dihasilkan oleh sistem berbasis unit pemrosesan pusat (CPU)-tradisional, khususnya untuk aplikasi visi komputer. Inilah sebabnya banyak perusahaan beralih ke-solusi akselerasi berbasis tensor-baik sebagai IP pada SoC atau sebagai-akselerator sistem-untuk mencapai waktu respons sub-detik yang diperlukan di edge. Kenyataannya adalah menghabiskan satu menit atau beberapa detik untuk memproses gambar dalam sistem penglihatan tidaklah terlalu berguna. Sistem visi industri menginginkan kecepatan pemrosesan-setingkat milidetik.
Memisahkan Pelatihan dan Inferensi
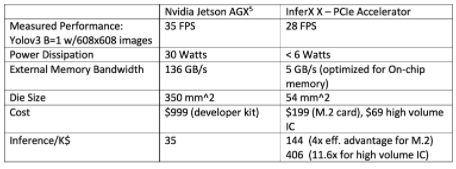
Menerapkan perangkat keras yang sama dengan yang digunakan untuk pelatihan guna menangani beban kerja inferensi dapat mengakibatkan kelebihan-penyediaan mesin inferensi dengan akselerator dan perangkat keras CPU. Solusi GPU yang dikembangkan untuk ML selama dekade terakhir belum tentu merupakan pilihan optimal untuk penerapan teknologi inferensi ML dalam skala besar. Diagram di bawah dengan sempurna menggambarkan perbandingan antara akselerator TPU dan akselerator GPU. Hal ini jelas menunjukkan bahwa akselerator TPU memberikan konsumsi daya yang lebih rendah, pengurangan biaya, dan efisiensi yang lebih tinggi dibandingkan dengan solusi AGX berbasis GPU, sekaligus tetap memberikan tingkat kinerja yang menarik untuk aplikasi inferensi.
Pertimbangan penting lainnya ketika mendekati solusi pelatihan dan inferensi ML adalah lingkungan perangkat lunak. Saat ini, banyak perpustakaan populer yang digunakan, seperti CUDA untuk GPU NVIDIA, kerangka kerja ML seperti TensorFlow dan PyTorch, perpustakaan model lintas platform-yang dioptimalkan seperti Keras, dan banyak lagi. Toolkit ini penting untuk mengembangkan dan melatih model ML, namun aplikasi inferensi memerlukan seperangkat alat software yang berbeda dan lebih kecil.
Perangkat inferensi fokus pada menjalankan model pada platform target. Mereka mendukung porting model terlatih ke platform, yang mungkin melibatkan beberapa transformasi operator, kuantisasi, dan layanan integrasi host. Namun, hal ini mewakili serangkaian fungsi yang relatif mudah dibandingkan dengan yang diperlukan untuk pengembangan model dan pelatihan.
Alat inferensi mendapat manfaat dari memulai dengan representasi model yang terstandarisasi. Open Neural Network Exchange (ONNX) adalah format standar untuk merepresentasikan model ML. Sesuai dengan namanya, ini adalah standar terbuka yang dikelola sebagai proyek Linux Foundation. Teknologi seperti ONNX memungkinkan pemisahan sistem pelatihan dan inferensi, memberikan kebebasan kepada pengembang untuk memilih platform berbeda yang dioptimalkan untuk masing-masing sistem.
Contoh Aplikasi Visual
Seiring dengan kemajuan dan perkembangan teknologi ML dan prosesor inferensi, aplikasi pun semakin banyak. Berikut adalah beberapa tempat di mana Anda mungkin akan menemukan teknologi ini di masa depan.
Server tepi di perusahaan seperti pabrik, rumah sakit, toko ritel, dan lembaga keuangan. Misalnya, di lingkungan industri, AI dapat membantu manajemen inventaris, deteksi cacat, dan bahkan pemeliharaan prediktif sebelum masalah muncul. Di ritel, ini mengaktifkan fitur seperti estimasi pose, menggunakan visi komputer untuk mendeteksi dan menganalisis postur manusia. Data dari analisis ini membantu pengecer-dan-mortar lebih memahami perilaku manusia dan lalu lintas pejalan kaki di dalam toko mereka, sehingga memungkinkan mereka mengoptimalkan tata letak toko untuk penjualan maksimum dan kepuasan pelanggan.
Pencitraan-presisi/-berkualitas tinggi untuk aplikasi termasuk robotika, otomasi/inspeksi industri, pencitraan medis, pencitraan ilmiah, kamera pengawasan dan pengenalan objek, serta fotonik. Misalnya, metode pembelajaran mesin telah menunjukkan kemampuan mendeteksi kanker dengan memproses sinar X-digital. Proses ini melibatkan pengembangan model ML yang dirancang untuk memproses gambar sinar X, biasanya menggunakan algoritme segmentasi semantik terlatih untuk mengidentifikasi lesi kanker. Selama pelatihan, gambar kanker yang diidentifikasi oleh ahli radiologi digunakan untuk mengajarkan jaringan apa yang bukan kanker, apa itu kanker, dan bagaimana berbagai jenis kanker muncul. Semakin sering model ML dilatih, semakin baik model tersebut dalam memaksimalkan diagnosis yang benar dan meminimalkan kesalahan diagnosis. Artinya, pembelajaran mesin tidak hanya bergantung pada desain model yang cerdas, namun juga pada sejumlah besar (puluhan ribu hingga jutaan) contoh data yang dikurasi dengan cermat di mana kanker telah diidentifikasi secara ahli.
Keranjang Belanja Cerdas-Beberapa perusahaan sedang mengembangkan dan menerapkan sistem belanja cerdas yang mengenali produk bukan dari kode batang UPC mereka, namun dari tampilan visual kemasan itu sendiri. Fitur ini memungkinkan pembeli untuk dengan mudah memasukkan barang ke dalam keranjang atau sistem pembayaran tanpa perlu mencari kode UPC dan memindainya dengan pemindai laser UPC. Teknologi ini membuat proses belanja menjadi lebih akurat, cepat, dan nyaman.
Membuat Keputusan yang Tepat
Perusahaan harus mengevaluasi semua solusi yang tersedia saat ini dan memilih solusi optimal berdasarkan kasus penggunaan spesifik mereka. Mereka juga tidak bisa begitu saja berasumsi bahwa semua solusi AI paling baik diterapkan pada perangkat GPU, karena solusi berbasis TPU-menawarkan efisiensi pemrosesan yang lebih tinggi dan pemanfaatan silikon yang lebih rendah, sehingga mengurangi konsumsi daya dan biaya.